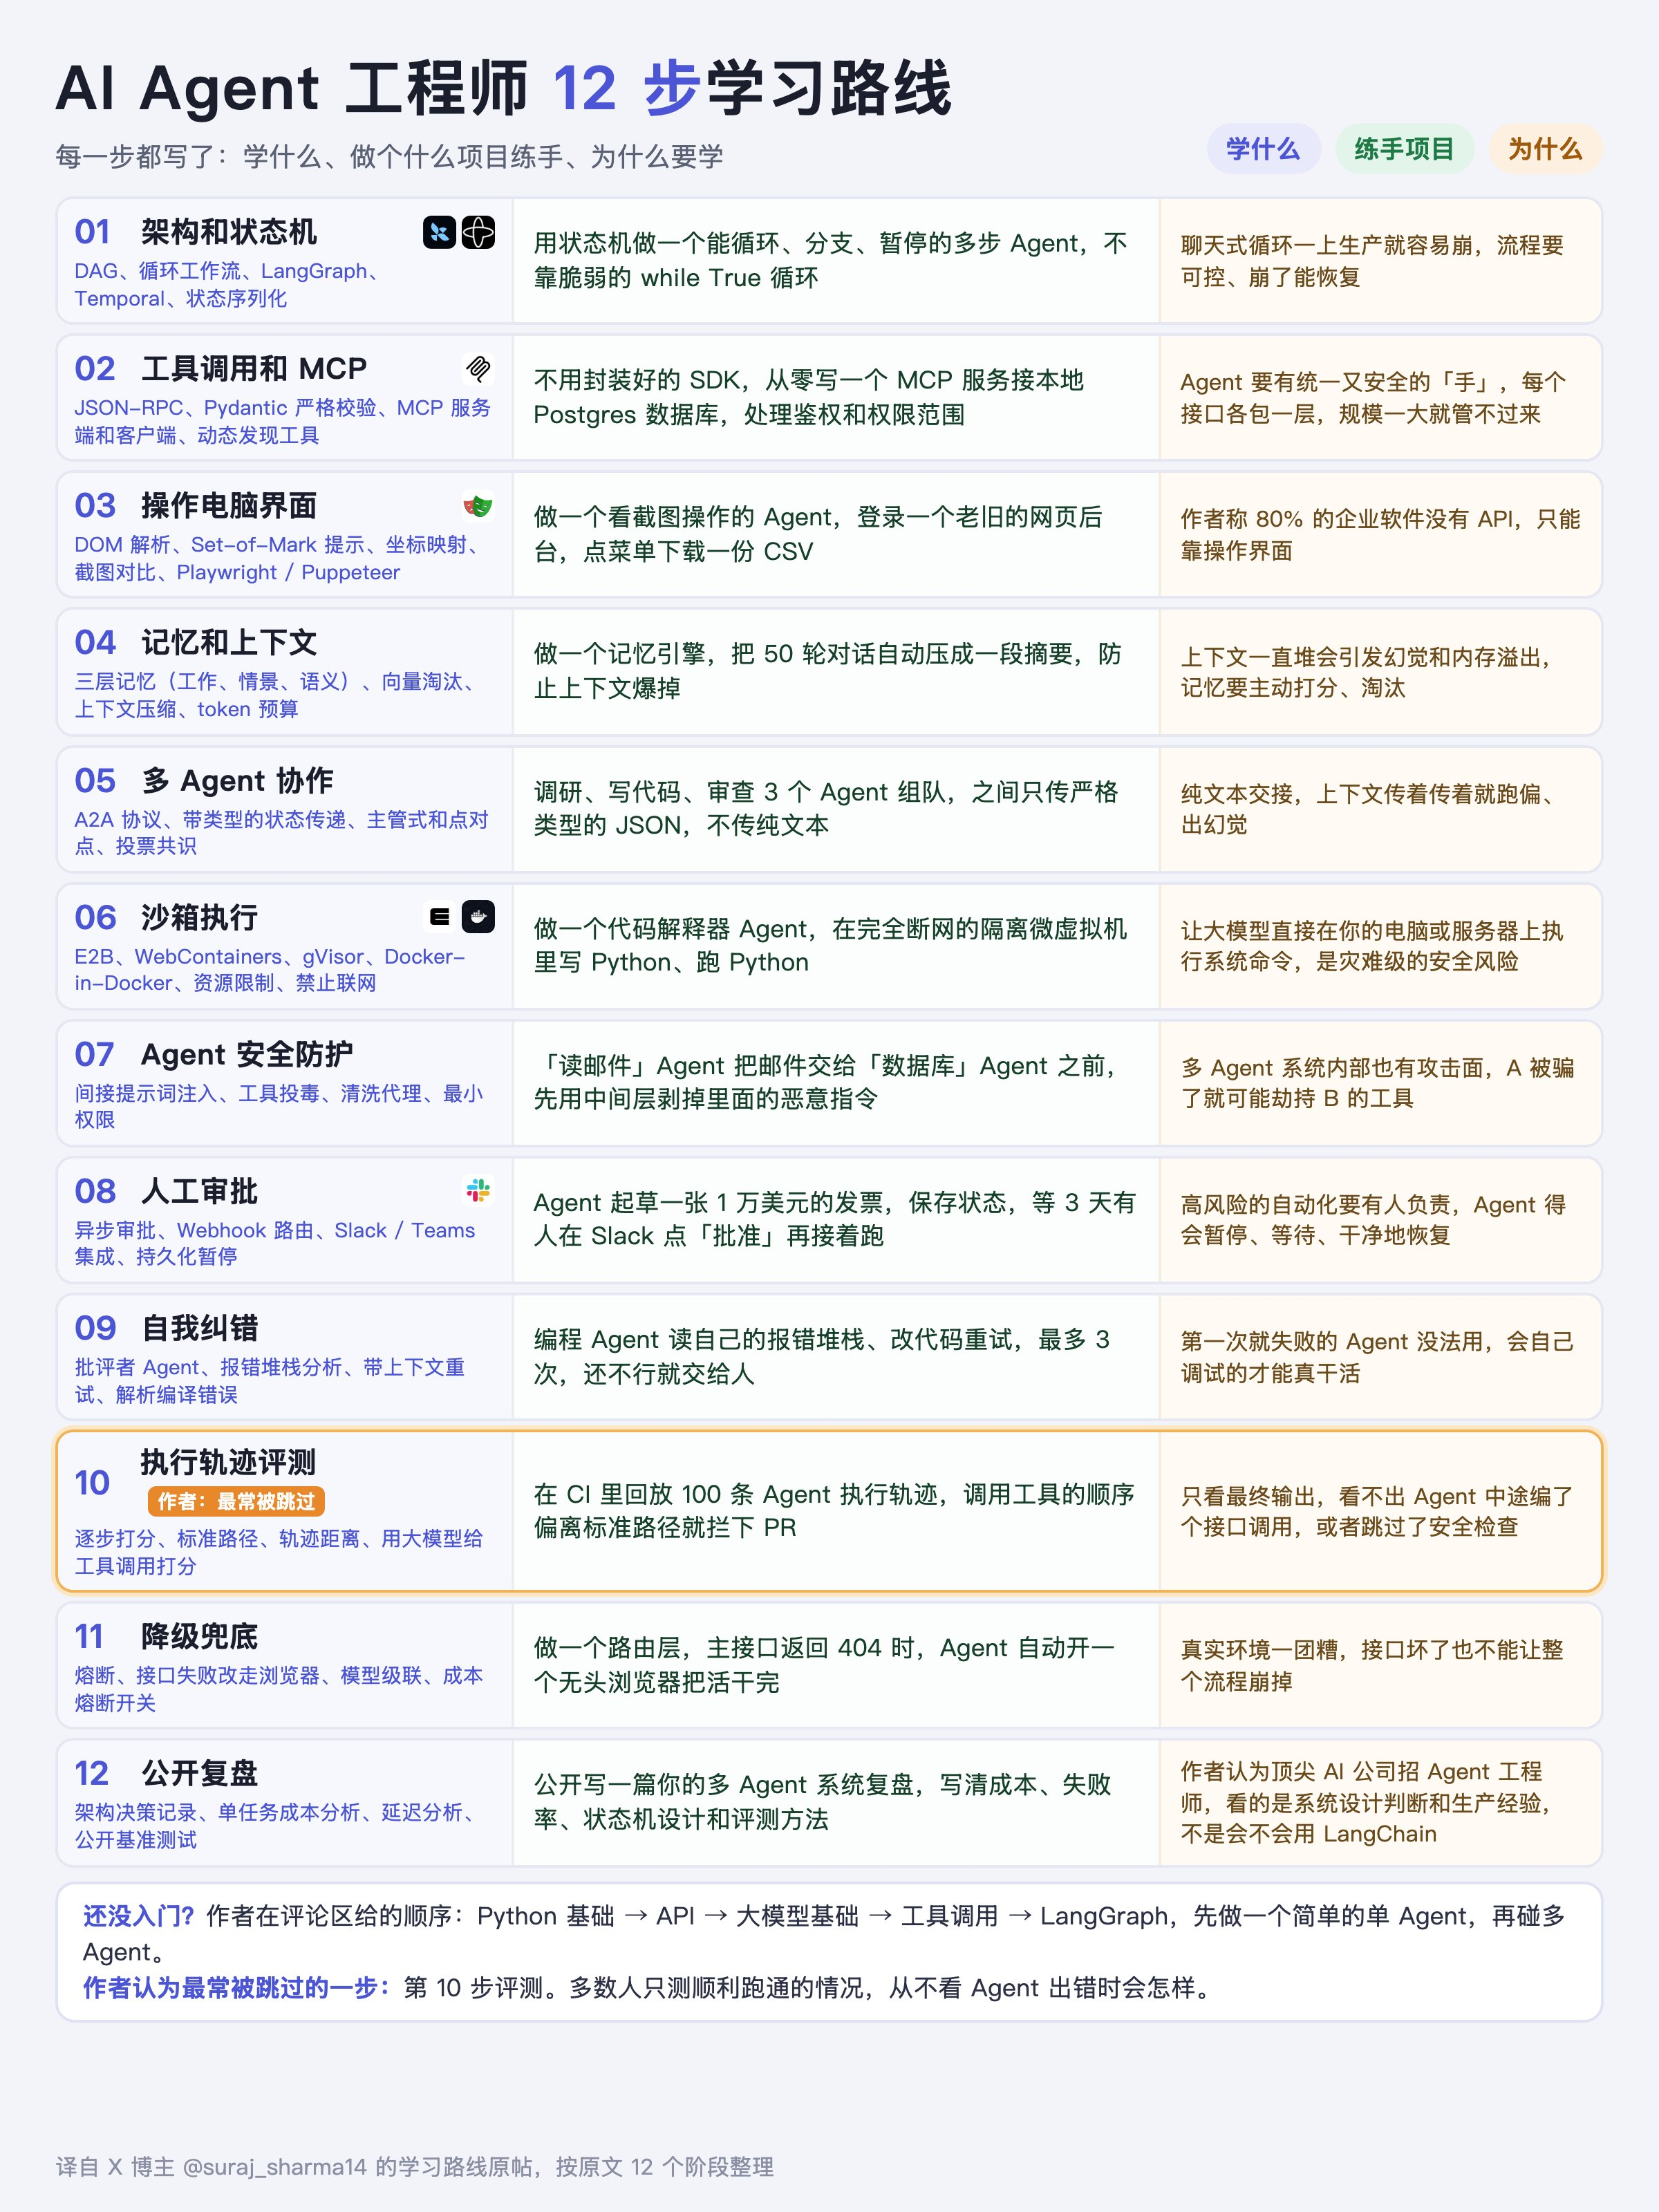
Agent 工程师入门学习路线
目标:围绕已有模型,把检索、工具、上下文和业务系统接起来,让 Agent 能完成具体任务。
Agent 工程师的核心其实就一条:让不可靠的模型输出可靠的结果,其他技能都是围着这条转的。
读的时候带着一个问题:学完这一部分,我能做出什么,又该怎么验证自己学会了?
学习路线总览
| 阶段 | 核心目标 | 交付物 |
|---|---|---|
| LLM 基础 | 搞清楚一次模型调用 | API Playground |
| Prompt Engineering | 把任务、材料和验收说清楚 | 贯穿所有项目 |
| RAG | 把资料变成可检索、可引用的证据 | RAG + Tool Calling Agent |
| Agent 应用 | 理解循环、状态、边界 | 简化 Coding Agent |
| 后端工程 | 让 Agent 变成可运行、可维护的服务 | AI 服务后端系统 |
Prompt 设计贯穿全程,每个项目至少保留 3 组修改前后的效果对比。
1. LLM 基础:先把一次模型调用看明白
这是后面所有内容的底座。重点放在真正影响系统行为的几个问题上,而不是死记训练细节。
需要建立的认识
- Token 与上下文窗口:输入 / 输出 Token、Context Window、溢出处理、Lost in the Middle
- 采样参数:Temperature、Top-p、Top-k、Frequency / Presence Penalty、Seed、Stop Sequences(不同供应商支持范围不同)
- 模型类型:Chat、Reasoning、多模态、Embedding、Rerank
- API 协议:message / role / content、tools、tool_choice、response_format、stream、usage、finish_reason
- 流式输出:SSE、delta、中断与取消
- 结构化输出:JSON Mode vs Schema 约束(结构对 ≠ 事实对)
- 工具调用:模型只发起请求,业务系统负责校验与执行,再把结果返回
- 多轮会话:历史由系统管理,独立请求不会自动继承聊天记录
推荐实践:大模型 API Playground
做一个支持普通对话、流式、结构化输出、工具调用、Embedding 的小应用。
验收:能讲清一次请求到响应的全过程,演示完整工具调用和结构化输出失败处理。
2. Prompt Engineering:把任务说清楚
没有单独项目,贯穿后面所有练习。
基本组成
- Role / System Prompt
- Instruction(任务描述)
- Context(上下文)
- Input(输入数据)
- Output Format + Constraints
常用思路
- Zero-shot / Few-shot
- CoT(拆解推理)
- ReAct(推理 + 行动)
- Self-Critique / Reflexion(检查与修正)
注意:对某些推理模型,强行加“一步一步思考”未必有收益。模型自查后仍需外部依据(测试、引用、字段校验)。
每个项目 README 里记录:用了什么结构、为什么这样设、Few-shot 是否有效、不确定/越界/格式错误怎么处理。
3. RAG:把资料变成可引用的证据
完整链路:加载解析 → 分块 → Embedding → 索引 → 召回 → 重排 → 上下文组织 → 生成 → 引用溯源 → 评估。
关键点
- 解析与分块直接影响检索质量(固定长度 / 递归 / 语义 / 按结构、overlap)
- 检索:向量 + 关键词(BM25)混合,配合元数据过滤(尤其是权限)
- Rerank:粗排 + 精排
- 生成时明确要求依据检索内容,资料不足时拒答
- 评估:检索准确率 / 召回率、答案忠实度、幻觉率(可用 Ragas)
推荐实践:RAG + Tool Calling Agent
支持上传 Markdown / PDF,回答能引用来源,资料不足时拒答;至少实现 2 个工具。
准备 ≥20 条测试问题(直接可查、跨文档、需工具、无答案、工具失败)。
验收:讲清 RAG 链路,提供检索结果与失败案例分析。
进阶(基础跑通后再看):Query Rewrite、HyDE、Agentic RAG、GraphRAG。
4. Agent 应用:先理解循环,再补状态与边界
核心循环
模型提出下一步 → 系统执行并返回结果 → 模型根据新结果继续 → 直到完成或触发停止条件。
建议先用极简 Harness(如 Pi)把循环跑通,再对照更完整的实现。
需要掌握的能力
- 工具设计:描述、Schema、错误返回、超时与重试、并行调用
- 规划与拆解:Plan-and-Execute、动态重规划、最大步数 / 预算
- 状态管理:会话历史、工具记录、任务进度、持久化与恢复
- Workflow 模式:Chaining、Routing、Parallelization、Orchestrator-Workers、Evaluator-Optimizer(按任务选用)
- 记忆:短期 / 长期,存什么、何时取回(存下来 ≠ 自动利用)
- 上下文工程:选择、裁剪、压缩、动态注入
- MCP:Tools / Resources / Prompts 的接入方式
- Human-in-the-Loop:审批、中断、恢复
- 安全:Prompt Injection、工具权限、沙箱、敏感数据、外部内容不可信
- 评估:任务完成率、工具调用准确率、步骤合理性、成本与延迟
推荐实践:简化 Coding Agent
参考 learn-claude-code 一类教学项目,完整读源码 → 从零实现自己的版本 → 修改一个机制(错误处理 / 权限 / 上下文压缩)并用测试观察变化。
5. 后端工程:让 Agent 能上线
进入真实使用后会遇到的问题:多人请求、长任务、会话保存、失败恢复、测试与部署。
建议技术栈(Python 向)
- 异步与 API:asyncio、FastAPI、Pydantic
- 数据:SQLAlchemy 2.0 + Alembic + PostgreSQL(含 pgvector)
- 缓存与队列:Redis、RabbitMQ(或同类任务队列)
- 工程化:pytest、Docker Compose、GitHub Actions
推荐实践:AI 服务后端系统
FastAPI 提供 REST API,PostgreSQL 存用户 / 会话 / 消息 / 任务,Redis 做缓存或状态,后台队列处理长任务。
验收:一条命令启动、能访问 API 文档、一条命令跑测试,能解释数据库设计与错误处理。
Kubernetes 与微服务放到基础服务跑稳之后再学。
实战项目建议(按切口选 1–2 个深入)
| 类型 | 推荐项目 | 学习重点 |
|---|---|---|
| Coding Agent | Pi、Codex CLI | Agent Loop、工具执行、权限、Extension |
| Working Agent | WorkBuddy(体验)、OpenWork(源码) | 任务界面、执行状态、产物交付 |
| 常驻助手 | nanobot → OpenClaw | 消息入口、会话、记忆、定时任务、沙箱 |
| Personal Agent | OpenBot、OpenDots | 环境隔离、权限策略、多入口、人工确认 |
每个项目交付时:代码 + 文档 + 运行说明 + 测试,放进 GitHub。
能回答:输入是什么、输出是什么、成功标准、哪里容易失败、失败后怎么处理。
起步建议
- 已有后端经验:直接从 API Playground 开始,同时补模型基础。
- 编程基础还不稳:先补 Python、Git、HTTP、JSON、基本接口开发,再进入第一阶段。
- 向量索引算法、Advanced RAG、复杂记忆、K8s 等,等基础项目产生具体需求后再深入。
- 项目可复用:后端服务承载前面做好的 RAG 和 Agent 能力,逐步补状态、测试、部署。
文档可以结合 AI 学,但每次让 AI 生成实现后,务必亲手跑一个正常案例和一个异常案例,并试着解释执行过程。
学习进度以能否解释、修改和验证为准,而不是收藏了多少仓库。